
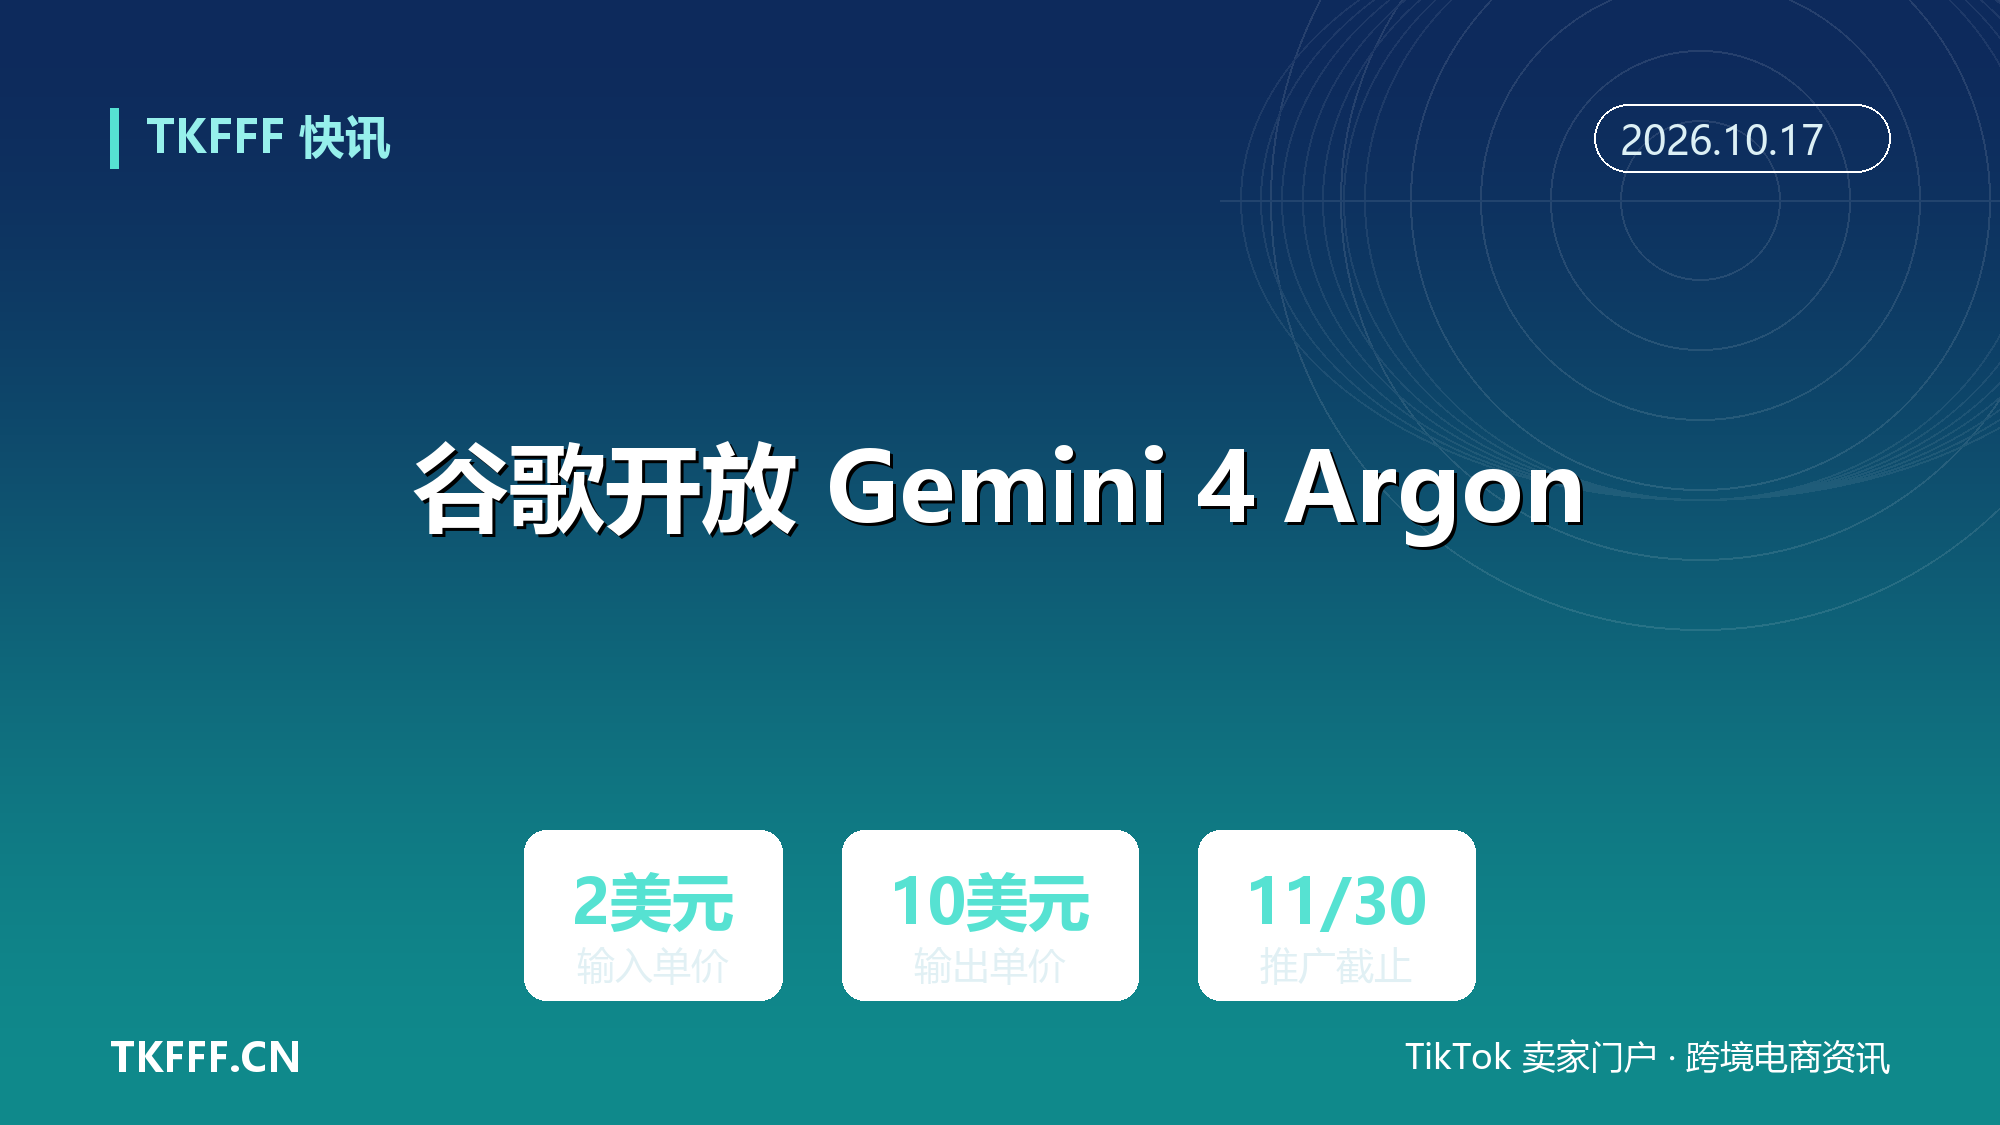
谷歌开放 Gemini 4 Argon:推广期输入2美元输出10美元每百万token,单次支持百万级输出
谷歌把 Gemini 4 系列的第一款模型,做成了一个「不快但能一口气写完」的东西。
Gemini 4 Argon 于2026年10月13日全面开放,推广期内每百万输入token 2美元、输出token 10美元,12月1日起翻倍。对外宣传的卖点是「单次百万级输出」。
但「百万级输出」这句话需要拆开看:它不是输出上限独立拉到100万,而是输入、思考、输出共用同一个100万token的窗口。这个差别,直接决定你账单上那个数字。
一、开放时间线:宣布、GA、企业侧,分了三步
据 Apex Logic 整理的官方时间线,Gemini 4 Argon 并非一次性开放:
2026年9月30日,Google DeepMind 高级副总裁 Koray Kavukcuoglu 宣布该模型,首批访问给了 Fairwind Program 的可信网络安全防御方。
2026年10月13日,模型正式 GA:Gemini API 付费档、Google AI Studio 同步开放。
同日,它在 Google Cloud 的 Gemini Enterprise Agent Platform(即此前的 Vertex AI)上线,覆盖 global endpoint 及 us、eu 多区域。
Gemini 应用与搜索 AI Mode 也对 Google AI Pro 与 Ultra 订阅用户开放,Ultra 额度更高。
2026年10月14日,Google Cloud 宣布在 Gemini for business 与 Google Cloud 渠道提供。这也是不少中文报道把开放日记为10月14日的原因。
官方博客的脚注写得很明确:Gemini 应用与 AI Mode 限于 Ultra 与 Pro 订阅,Google Antigravity 则仅限 Ultra 订阅。
而在 API 层,免费方案与 Google AI Pro 方案不支持 Argon,必须走付费档。
二、定价:11月30日是一道分水岭
据 Google AI for Developers 文档,Gemini 4 Argon 的推广期价截至2026年11月30日:输入每百万token 2美元,输出(含思考token)每百万token 10美元。
2026年12月1日起恢复为输入4美元、输出20美元。
隐含缓存(implicit caching)把缓存输入的费用再打95折,降至每百万token 0.10美元,12月1日起为0.20美元。
两个细节容易被漏掉。其一,官方脚注注明推广价「仅适用于面向公众开放的 Argon 版本」。
其二,Argon 采用单一价格档,没有长上下文附加费。上一代 Gemini 3.1 Pro Preview 在提示词超过20万token后,价格会跳到4美元/18美元,Argon 没有这档跳变。
还有一点:输出token是包含思考token一起计费的。
据第三方测算,Argon 在 Artificial Analysis 的每任务平均输出约6.2万token,而 GPT-6 Astra 约2.7万。单价更便宜,但token消耗量翻倍,账要按总量算。
三、百万级输出:默认64K,长解码才到1M
这是最需要澄清的一点。
Argon 的上下文窗口是1,048,576 token,输入、思考、输出三者共享。默认单次输出上限仍是65,536 token(非流式REST为32,768)。
要突破64K,需要显式开启长解码:在 Interactions API 中设置后台执行,并把 max_output_tokens 调到65,536以上。服务端会以64K为一跳持续写入,最长可跑24小时。
长解码的上限是「1M减去你的输入」。如果提示词占了90万token,留给思考和回答的空间只剩约15万。
思考级别可调 low、medium(默认)、high,且不能关闭。谷歌建议大多数任务用 medium,最难推理才用 high。但要注意:目前所有公开的基准成绩都是在 high 档跑出来的,medium 档的实际表现尚无公开数据。
四、批量生成商品详情与客服话术:一笔成本账
长输出真正改变的是批量任务的工程结构。
过去用64K输出上限的模型批量写多语言商品详情,必须自己切块、续写、拼接,命名不一致、丢导入、语法断裂是常态。Argon 的长解码允许一次请求吐出完整的多文件差异、测试套件或长篇文档,省掉的是这部分拼接工程。
算一笔具体的账。假设一个卖家要为1万个SKU生成5个语种的商品详情,共5万条;每条约1,200输出token(含思考),合计6,000万输出token。
推广期内,输出成本为600美元;12月1日起,同一批任务变成1,200美元。
输入侧:每个SKU的规格属性表约800 token,若作为共享前缀命中隐式缓存,成本降至每百万token 0.10美元,几乎可以忽略;未命中缓存则按2美元计,5万次×800 token共4,000万token,约80美元。
结论是:这类任务里,输出token是成本大头,缓存与提示词结构决定输入侧能不能压到最低。
五、别急着一刀切:三个真实约束
第一,速度。据第三方实测,Argon 在 high 思考档下,首个回答token约需45秒。批量任务可以后台跑,交互式客服话术场景未必等得起。
第二,能力分布不均。Artificial Analysis 智能指数上 Argon 得53分,与 GPT-6 Astra 持平,但低于 Claude Opus 5.5(58)与 Sonnet 5.5(56)。
在终端密集型编码与计算机操作上,它落后于对手。强项是知识工作与超长输入——GraphWalks 256k至1M 区间得分84.2%。
第三,它会「拒答」。Argon 的幻觉率15%,是头部模型里最低的,但在同一批问题上的正确率只有50%——也就是说,不确定时它倾向于不回答,而不是编一个。批量生成场景下需要设计兜底重试。
所以,Gemini 4 Argon 的百万级输出,并不意味着你可以一次把整站商品文案生成完,而是意味着切块拼接这层工程量被平台接走了。
真正的变量在日历上:11月30日之后价格翻倍。那些打算把 Argon 跑进日常生产流程的团队,是抢在翻倍前把批量任务跑完,还是重新算一遍单位成本?
答案取决于每千token能换回多少转化,而不是模型有多强。
六、参考资料
- Google 官方博客:《Gemini 4 Argon: Built to solve your hardest problems》
- Google AI for Developers:《Gemini 4 Argon 新功能》(模型与定价文档)
- Google AI Studio:《Gemini 4 Argon: Developer Guide》
- Apex Logic:《Gemini 4 Argon: Release Date, Features, Specs and Pricing》
- AIHubMix:《Gemini 4 Argon: Frontier Scores, a 1M-Token Output Limit, and How to Call It Now》
- Gadgets Focus:《Gemini 4 Argon Explained (2026): 1M Output Tokens, Benchmarks, Pricing》