
GPT-5.3 Codex 发布:终端直接执行命令、77.3% Terminal Bench、--steerable 实时干预
OpenAI 发布 GPT-5.3-Codex,官方称其为目前能力最强的智能体代码编写模型:速度比 GPT-5.2-Codex 快 25%,Terminal-Bench 2.0 拿到 77.3%,支持运行中实时引导(--steerable)而不丢上下文。对卖家来说,能放心委派的是报表、脚本和批量文件处理;不能放手的是资金、账号后台和对外发布。
变在哪:从「写代码」到「在终端里干活」
官方对 GPT-5.3-Codex 的定位是「目前能力最强的智能体代码编写模型」。它整合了 GPT-5.2-Codex 的前沿编程能力与 GPT-5.2 的推理和专业知识能力,速度提升 25%,用于需要研究、工具操作与复杂执行流程的长时间任务。关键区别在于工作位置:它不是只在对话框里生成代码片段,而是训练它在终端直接执行 CLI 命令、运行测试、修 lint 错误、直接操作本地代码库文件。官方还提到一个信号——它是第一个在自身打造过程中发挥关键作用的模型,Codex 团队用早期版本调试训练流程、管理部署、诊断测试与评估结果。另一个实用点是 token 效率:官方称其在达成这些基准成绩时使用的 token 数量比任何过往模型都更少,意味着同等预算能跑更多任务。可用渠道包括 Codex 应用、CLI、IDE 扩展、云和 Web 端。
77.3% 是什么水平:四项基准一起看
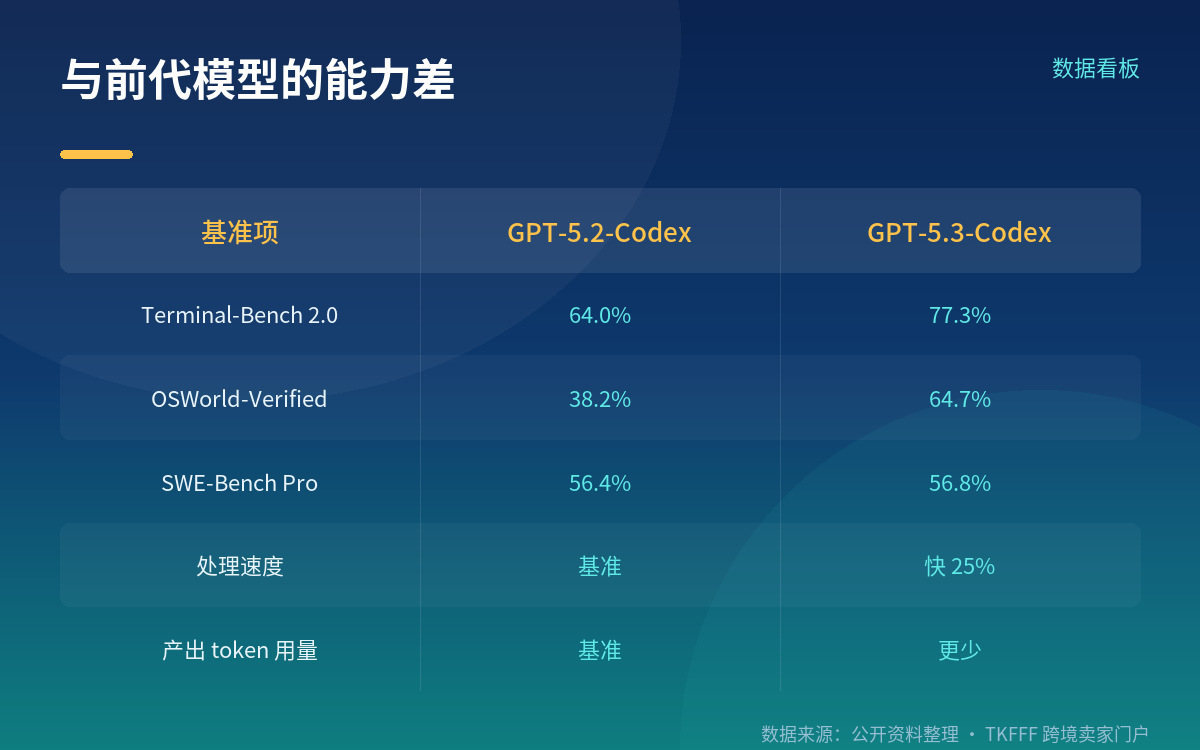
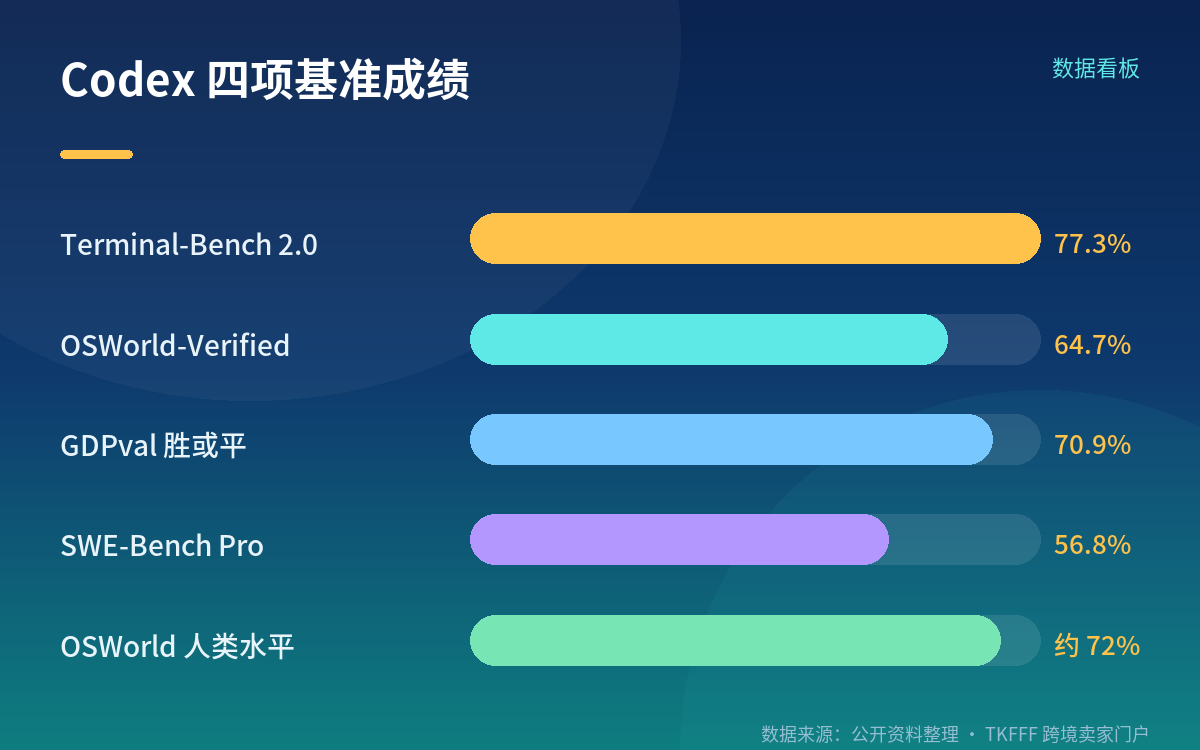
Terminal-Bench 2.0 衡量的是编码智能体在真实终端环境中的操作能力,GPT-5.3-Codex 得分 77.3%,比 GPT-5.2-Codex 的 64.0% 高 13.3 个百分点。第三方横向对比口径为:Terminal-Bench 2.0 上 Claude Opus 4.6 得 65.4%、Gemini 3.1 Pro 得 54.2%。SWE-Bench Pro 覆盖 Python、JavaScript/TypeScript、Java、Go 四种语言,GPT-5.3-Codex 得 56.8%,前代分别是 56.4% 和 55.6%——这一项提升是渐进的。OSWorld-Verified 衡量可视化桌面环境下的电脑操作,GPT-5.3-Codex 得 64.7%,较前代的 38.2% 接近翻倍,而人类得分约 72%,也就是说它尚未追平人类在通用桌面任务上的水平。GDPval 覆盖 44 种职业的知识工作任务,该模型以 70.9% 的胜或平与 GPT-5.2 相当。综合看:终端与电脑操作是强项,纯代码生成的提升有限,桌面自动化仍有人类差距。
--steerable 怎么用:跑到一半改方向,不用重开
这是本轮最实用的变化。官方表述是:你可以在 GPT-5.3-Codex 工作时引导模型并与之互动,而不会失去既有的背景脉络。具体表现是模型会更频繁地提供进度更新,让你随时掌握关键决策与执行进度;你不必等最终结果出来才介入,而是可以实时提问、讨论做法、引导方向。Codex 官方更新日志里把这项能力描述为「不中断活动响应地重定向 Codex」的中途引导。启用路径在 Codex 应用的设置 > 一般 > 跟进行为里打开模型运作时的引导功能。实操价值很直接:把「等长任务跑完才发现方向全错」变成「跑偏几十秒就拽回来」,尤其在批量处理和重构这类容易一路错到底的任务上。
发布节奏与已知边界:先确认你账号能用哪个模型
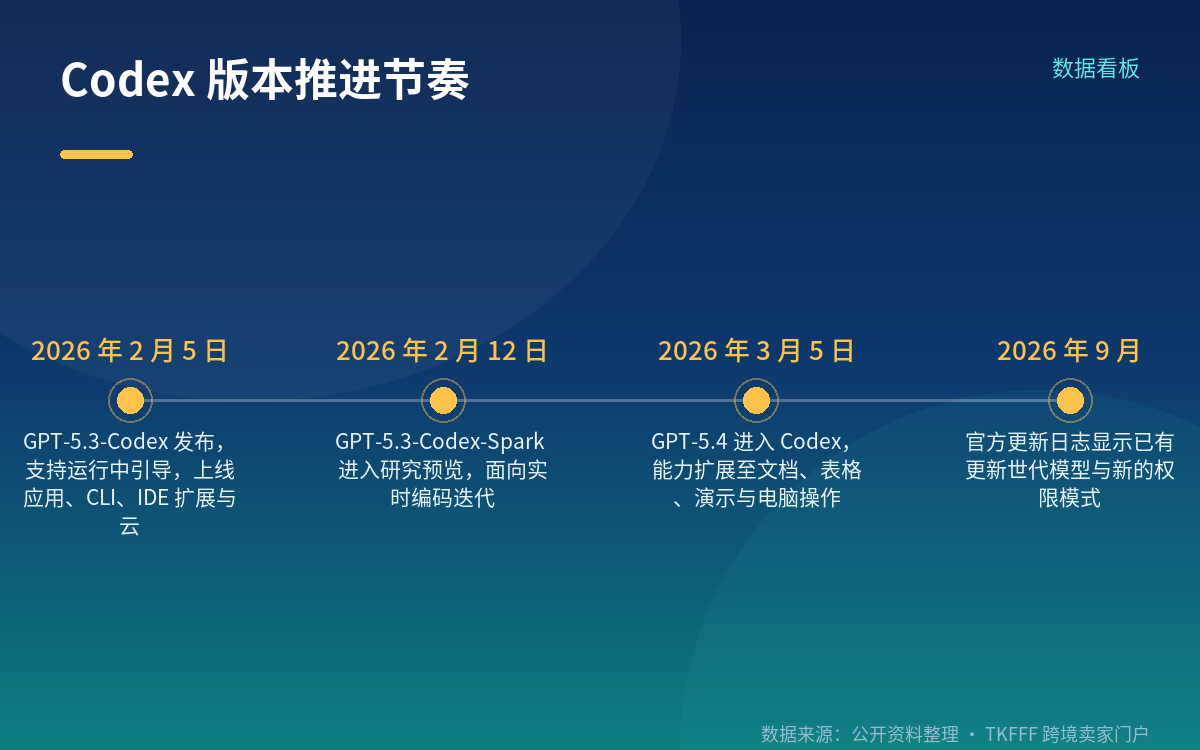
这里有个容易误判的点。据 Codex 官方更新日志整理的时间线,GPT-5.3-Codex 于 2026 年 2 月 5 日发布,2 月 12 日跟进 GPT-5.3-Codex-Spark 用于实时编码迭代;3 月 5 日 GPT-5.4 进入 Codex,把能力扩展到文档、表格、演示与电脑操作。9 月仍有不少媒体在做二次评测与功能整理,容易让人误以为是新发布。同期 Codex 官方更新页面显示已有更新世代模型与新的权限模式,所以上手前先确认当前账号可用的模型版本、权限模式(默认权限 / 本地 / 工作树)和订阅档位。已知短板来自第三方评测总结:长周期、非结构化文档任务上会出现上下文漂移;倾向于跳过澄清提问,快但更容易产生幻觉;保守的过滤器会过度拒绝合法的安全与重构任务。
注意事项
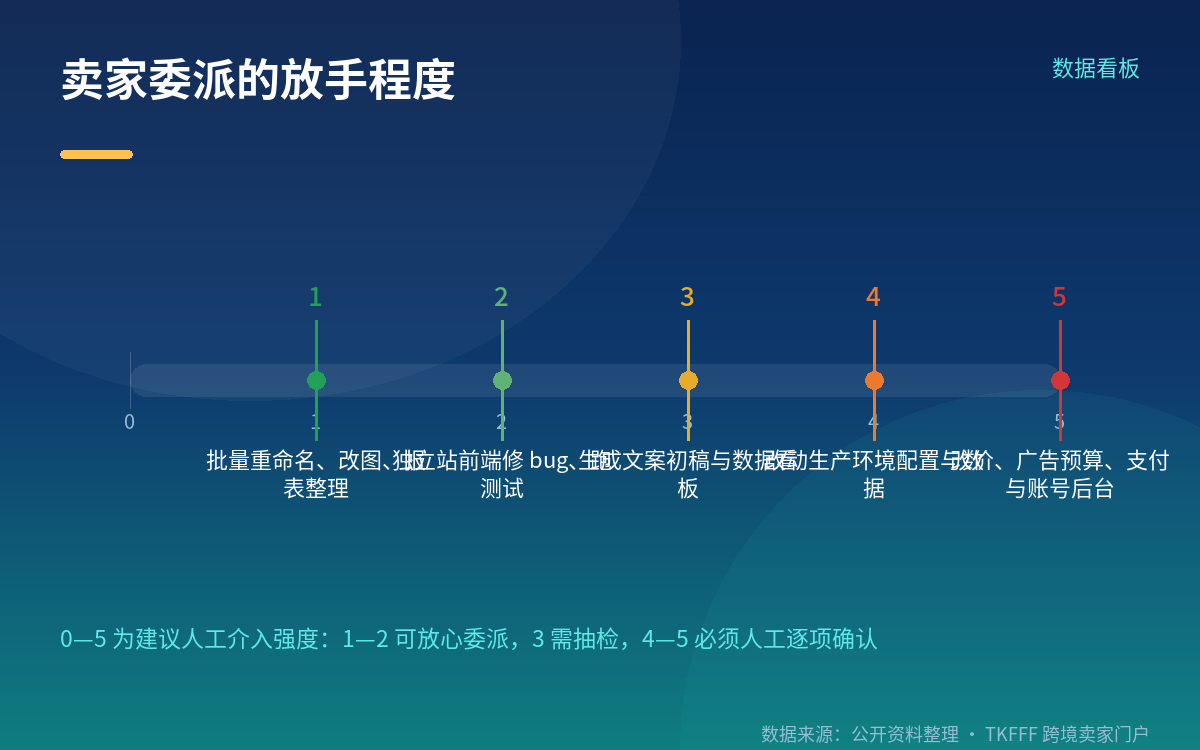
第一,能放心委派的:批量脚本与文件处理。例如按规则批量改图片尺寸和重命名、把广告与库存报表整理成一页看板、跑对账脚本核对平台结算数据与内部台账、给独立站前端修 bug 并跑测试、批量生成 listing 文案初稿。这类任务都在本地文件或代码仓库里,出错了可回滚,试错成本低。
第二,必须人工确认的:任何碰到钱和账号的操作。改价、调广告预算、动支付与物流 API 密钥、登录平台后台改 listing、导出客户数据、删除文件、把改动推送到生产分支——一律人工最后点确认。同时把权限模式设为最小必要,不要图省事直接给高权限,因为模型存在跳过澄清提问、自行假设的情况。
第三,别把基准分当成结论正确率。模型在长文档上会漂移,涉及申报口径、税务处理、产品认证文案的判断,必须回到原始政策文件核对。基准测试衡量的是特定任务集上的表现,不等于你的实际业务场景一定成立。建议先用一个真实但可回滚的任务做验证,再逐步扩大委派范围。
FAQ
Q:GPT-5.3-Codex 主要升级了什么? A:官方称其为目前能力最强的智能体代码编写模型,速度比 GPT-5.2-Codex 快 25%,在终端环境中可直接执行 CLI 命令、跑测试、修 lint、操作本地文件;Terminal-Bench 2.0 得分 77.3%,OSWorld-Verified 64.7%,并支持运行中实时引导。
Q:--steerable 是什么,怎么开? A:指中途引导能力。你可以在模型工作时提问、讨论做法并调整方向,而不会丢失既有上下文,不必等结果出来再重做。在 Codex 应用的设置 > 一般 > 跟进行为里启用模型运作时的引导功能。
Q:卖家用它做什么最划算,哪些不能交给它? A:适合委派批量文件处理、报表整理、对账脚本、独立站代码修复与文案初稿。涉及资金(改价、广告预算)、账号后台操作、密钥、客户数据、删除文件和推送生产分支的操作,必须人工逐项确认;涉及合规与税务口径的结论必须回原始文件核对。
参考来源
- OpenAI:《GPT‑5.3‑Codex 登場》(官方发布说明)
- OpenAI Developers:《Codex — What's new》(功能更新日志)
- Terminal-Bench 2.0 官方榜单
- SWE-Bench Pro、OSWorld-Verified、GDPval 基准公开数据
- AI Rockstars:《GPT-5.3 Codex: The autonomous coding agent is here》
- Git AutoReview:《GPT-5.3-Codex for Code Review: The Speed Machine》
- ScriptByAI:《Codex Timeline: Release Dates and Major Updates (2026)》
- DEV Community:《GPT‑5.3‑Codex vs Claude Opus 4.6: benchmarks, cost, and workflow tradeoffs》